robots.txt: що це і як правильно налаштувати

robots.txt - текстовий файл у корені сайту, який каже пошуковим роботам, які розділи можна обходити, а які не варто. Це перше, що читає краулер, зайшовши на домен, і одна з небагатьох речей, якою можна за хвилину вимкнути сайт із пошуку повністю.
Файл простий до примітивності: кілька рядків тексту без жодного програмування. Саме через цю простоту з ним і роблять найдорожчі помилки. За нашою практикою, закритий від індексації сайт через один зайвий рядок у robots.txt - у трійці найчастіших причин, чому «сайт зробили, а трафіку немає».
1. Де лежить і як подивитися
Файл має лежати у корені домену і бути доступним за адресою виду https://example.com/robots.txt. Іншого місця не існує: файл у підпапці робот просто не побачить.
Щоб подивитися чужий або свій robots.txt, достатньо дописати /robots.txt до адреси сайту і відкрити в браузері. Це публічний файл, його бачать усі.
Два обмеження, про які варто знати. Робот читає файл окремо для кожного протоколу і піддомену: https://example.com/robots.txt і https://shop.example.com/robots.txt - це два різні файли. І Google враховує лише перші 500 КіБ вмісту, решту ігнорує - на практиці в цю межу впираються хіба що згенеровані автоматом полотна на тисячі рядків.
2. Синтаксис: чотири директиви, і все
Google підтримує рівно чотири поля. Усе інше, що ви могли бачити в чужих файлах, він ігнорує.
User-agent - до якого робота стосуються правила нижче. User-agent: * означає «до всіх». Можна писати конкретного: Googlebot, Bingbot.
Disallow - який шлях не обходити. Disallow: /wp-admin/ закриває адмінку.
Allow - виняток із заборони. Потрібен, коли всередині закритого розділу є щось потрібне.
Sitemap - повна адреса карти сайту. Пишеться з протоколом і доменом, і стоїть окремо від блоків User-agent.
🔴 Crawl-delay Google не підтримує. Рядок можна лишати заради інших пошуковиків, але на Googlebot він не впливає ніяк. Швидкість обходу для Google регулюється не тут.
Так само не працює Noindex у robots.txt: Google офіційно перестав його розуміти ще в 2019 році. Якщо бачите цей рядок у чужому файлі - це спадщина, а не робочий інструмент.
Два спецсимволи: * замінює будь-яку кількість будь-яких символів, $ означає кінець адреси. Наприклад, Disallow: /*?sort= закриє всі адреси з параметром сортування, а Disallow: /*.pdf$ - усі PDF-файли.
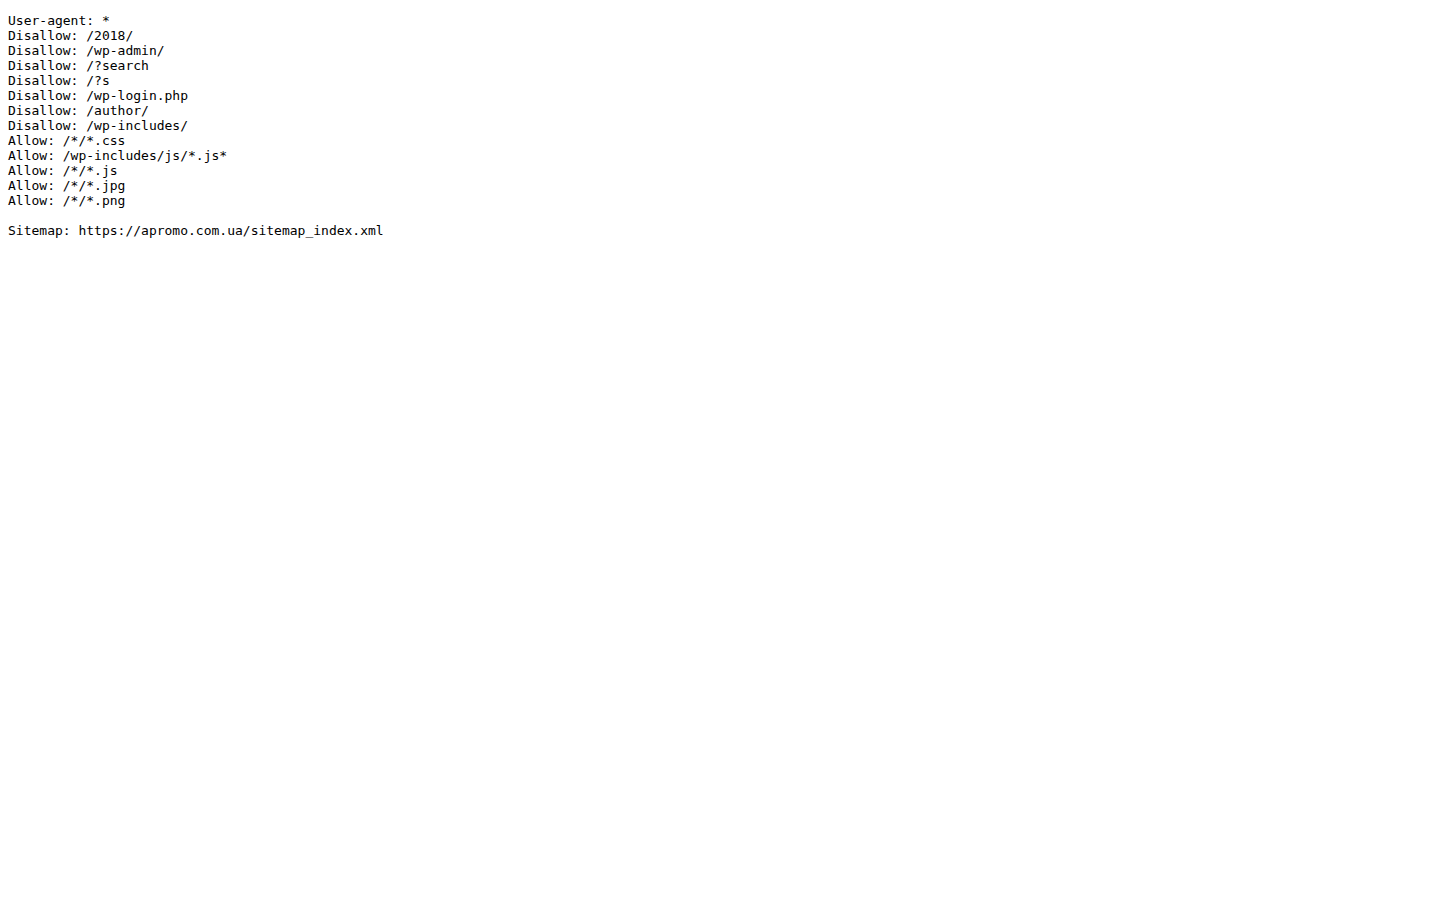
Ось як виглядає звичайний робочий файл на WordPress: закрита службова частина, відкриті стилі й скрипти, вказана карта сайту.
3. Головна пастка: Disallow не ховає сторінку з пошуку
Це непорозуміння коштує найдорожче, тому окремим розділом.
Формулювання Google дослівне: він не може індексувати вміст сторінок, закритих від обходу, але може індексувати саму адресу і показувати її в результатах пошуку без опису.
Тобто якщо на закриту сторінку є посилання з інших сайтів, вона цілком може зʼявитися у видачі - голим URL із формулюванням, що опис недоступний. Виглядає це гірше, ніж якби сторінка була відкрита.
Звідси практичне правило.
Треба, щоб сторінки не було в пошуку - використовуйте метатег noindex на самій сторінці, а в robots.txt її не закривайте. Бо якщо робот не може зайти на сторінку, він не побачить і вашого noindex. Ці дві заборони одночасно не працюють, вони конфліктують.
Треба, щоб робот не витрачав час на розділ - ось для цього robots.txt і призначений. Службові адреси, нескінченні фільтри, результати внутрішнього пошуку.
Треба, щоб сторінку не побачили сторонні - закривайте паролем. robots.txt нічого не захищає: він публічний, і перелік закритих розділів у ньому фактично є підказкою, де шукати цікаве.
4. Що закривати, а що ні
Закривати зазвичай варто:
Службові розділи. Адмінка, сторінки входу, кошик, особистий кабінет, порівняння товарів.
Результати внутрішнього пошуку. Це нескінченна кількість адрес із нульовою цінністю для пошуку.
Комбінації фільтрів і сортувань. Точніше - ті з них, які не мають попиту. Тут потрібна обережність: частина фільтрів на комерційних сайтах якраз і збирає трафік, і закривати їх усі одним рядком - типовий спосіб втратити відвідувачів.
Дублі з параметрами. UTM-мітки, ідентифікатори сесій.
🔴 Ніколи не закривайте CSS і JavaScript. Google рендерить сторінку так само, як браузер. Якщо стилі й скрипти закриті, він бачить поламану верстку і може вирішити, що сторінка не адаптована під мобільні. Тому в прикладі вище є явні Allow для css, js і зображень.
Так само не варто закривати зображення, якщо вам потрібен трафік із пошуку за картинками.
5. Як перевірити
Найшвидша перевірка - відкрити файл у браузері. Якщо там порожньо, віддається 404 або, гірше, HTML-сторінка замість тексту - файлу фактично немає.
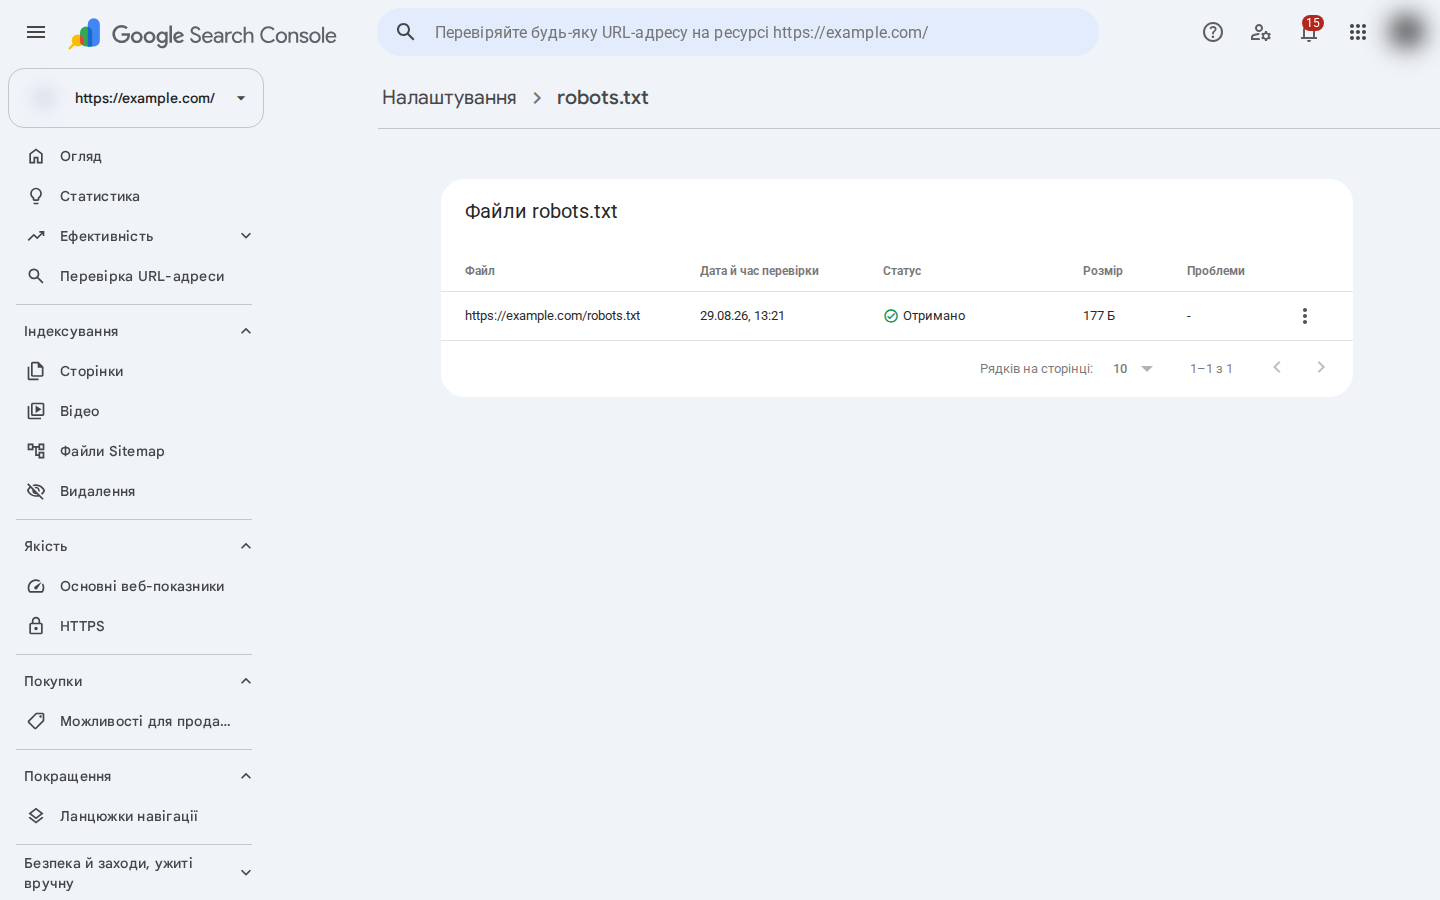
Далі Google Search Console, розділ Налаштування → robots.txt. Там видно, який саме файл бачить Google, коли він його востаннє читав, розмір і чи знайшов помилки. Це важливо: іноді на сервері лежить один файл, а віддається інший - через кеш, CDN або правила переадресації.
І третя перевірка, найпрактичніша: Перевірка URL-адреси в тій самій Search Console. Вставляєте адресу конкретної сторінки і дивитесь, чи не написано, що сканування заблоковано файлом robots.txt. Це єдиний спосіб переконатися, що важлива сторінка справді відкрита.
Поширені помилки
Disallow: / Один символ, який закриває весь сайт. Класика: розробник закрив тестову версію, сайт переїхав на прод разом із цим рядком. Перевіряти після кожного релізу - дешевше, ніж потім розбиратися, чому трафік зник.
Сайт закритий, а сторінки в індексі. Зворотна ситуація, і вона теж збиває з пантелику. Пояснення вище: Disallow забороняє обхід, а не індексацію адреси.
Закриті CSS і JS. Досі зустрічається в старих файлах, які копіювали з інструкцій десятирічної давнини.
Закриті всі параметри одним рядком. Разом зі сміттям під заборону потрапляють робочі сторінки фільтрів, які приносили трафік.
Немає рядка Sitemap. Не критично, бо карту сайту можна подати в Search Console, але це безкоштовний спосіб допомогти роботу знайти всі сторінки, і не використовувати його немає причин.
Файл віддається з неправильним типом. Має бути text/plain. Якщо сервер віддає його як HTML, робот може прочитати файл не так, як ви очікуєте.
Правила для неіснуючих розділів. Не шкідливо, але свідчить, що файл ніхто не переглядав роками: у ньому лишились заборони для CMS, з якої сайт давно переїхав.
6. Що робити просто зараз
Відкрийте свій /robots.txt і перевірте три речі: чи немає в ньому Disallow: /, чи не закриті css і js, і чи вказана карта сайту. Це займе хвилину і закриває більшість ризиків.
Якщо сайт великий і з фільтрами, окремо прогляньте, що саме потрапляє під заборони з масками. Одна зайва зірочка там закриває значно більше, ніж здається на перший погляд.