
Зміст:
1. Що таке семантичне ядро (СЯ) і навіщо воно потрібне для просування сайту
2. Навіщо збирати семантичне ядро
3. Способи та інструменти для швидкого збору та обробки СЯ
3.1. Web-интерфейс Serpstat
3.2. KeyCollector + Serpstat API
3.3. Google Spreadsheet API Serpstat
4. Автоматизації збору СЯ
5. Що таке кластеризація ключових слів
5.1. Автоматична кластеризація на основі семантичної схожості фраз
5.2. Ручна кластеризація на основі логічної релевантності фраз
5.3. Автоматична кластеризація на основі ТОП пошукових систем
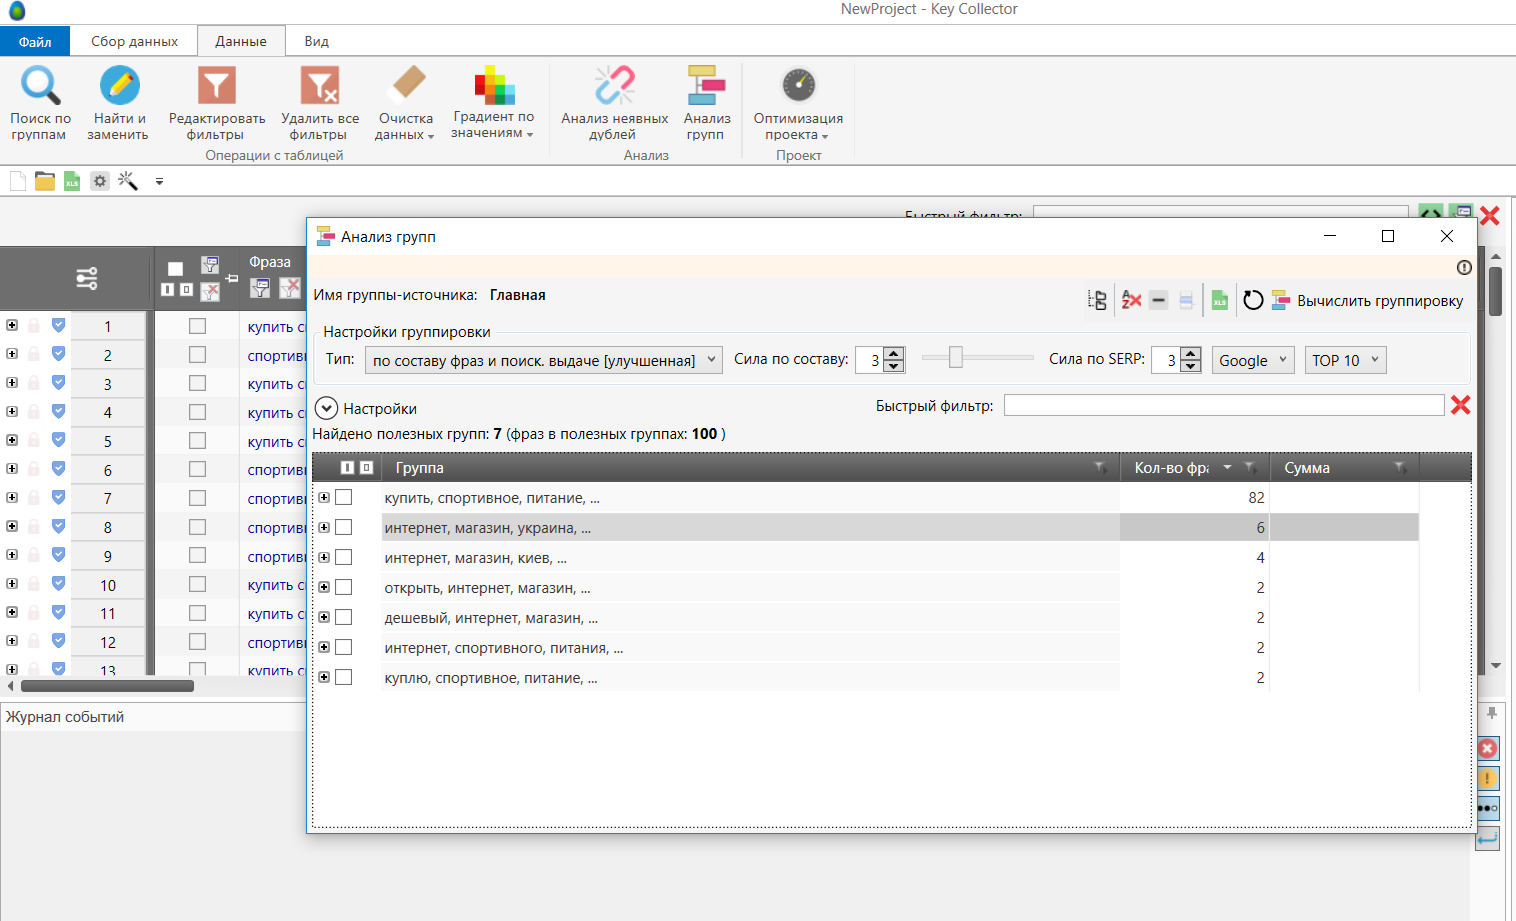
6. Інструменти для кластеризації ключових слів
1. Що таке семантичне ядро (СЯ) і навіщо воно потрібне для просування сайту
Семантичне ядро - це список ключових слів, словоформ, за якими планується просування сайту. Простіше кажучи це запити, за якими ваш сайт буде показуватися потенційним клієнтам, але з урахуванням попиту структури сайту та вимог пошукових систем.Тобто ключові слова підбираються не лише за відчуттями власника бізнесу, а на підставі статистики пошукових систем та бізнес-цілей. Нижче буде описано детальний процес збору СЯ.
2. Навіщо збирати семантичне ядро
СЯ дозволяє:- Зрозуміти потенціал трафіку за статистикою частотності ключових слів. Розуміючи яка частотність, можна приблизно спрогнозувати відсоток переходу за ключовими словами, що дасть розуміння, скільки трафіку можна отримати при досягненні ТОП.
- Зробити максимально повну та правильну структуру сайту або доповнити поточну, оскільки у процесі виявляються нові запити (потреби).
- Правильно розставити пріоритети просування на основі даних щодо частотності та конкуренції в окремих групах запитів.
- Зробити правильне ТЗ за текстами.
- Вимірювати динаміку позицій
3. Способи та інструменти для швидкого збору та обробки СЯ
Нижче буде описано кілька способів збору СЯ, які ми використовуємо, хоча головне - це зрозуміти загальну логіку, але також важливо збільшити швидкість збору та обробки тому нижче будуть деякі інсайти як можна прискорити процес.Для початку потрібно визначитися для якої пошукової системи та країни буде просування. Припустимо, що завдання просування інтернет-магазину спортивного харчування. Для початку нам потрібно ознайомитися з асортиментом, кількома категоріями і т.д.
Допустимо наступну структуру:
- Головна
- Гейнери
- Жироспалювачі
- Протеїни
3.1 Web-інтерфейс Serpstat
Заходимо до Serpstat.com вибираємо Google.com.ua та шукаємо запити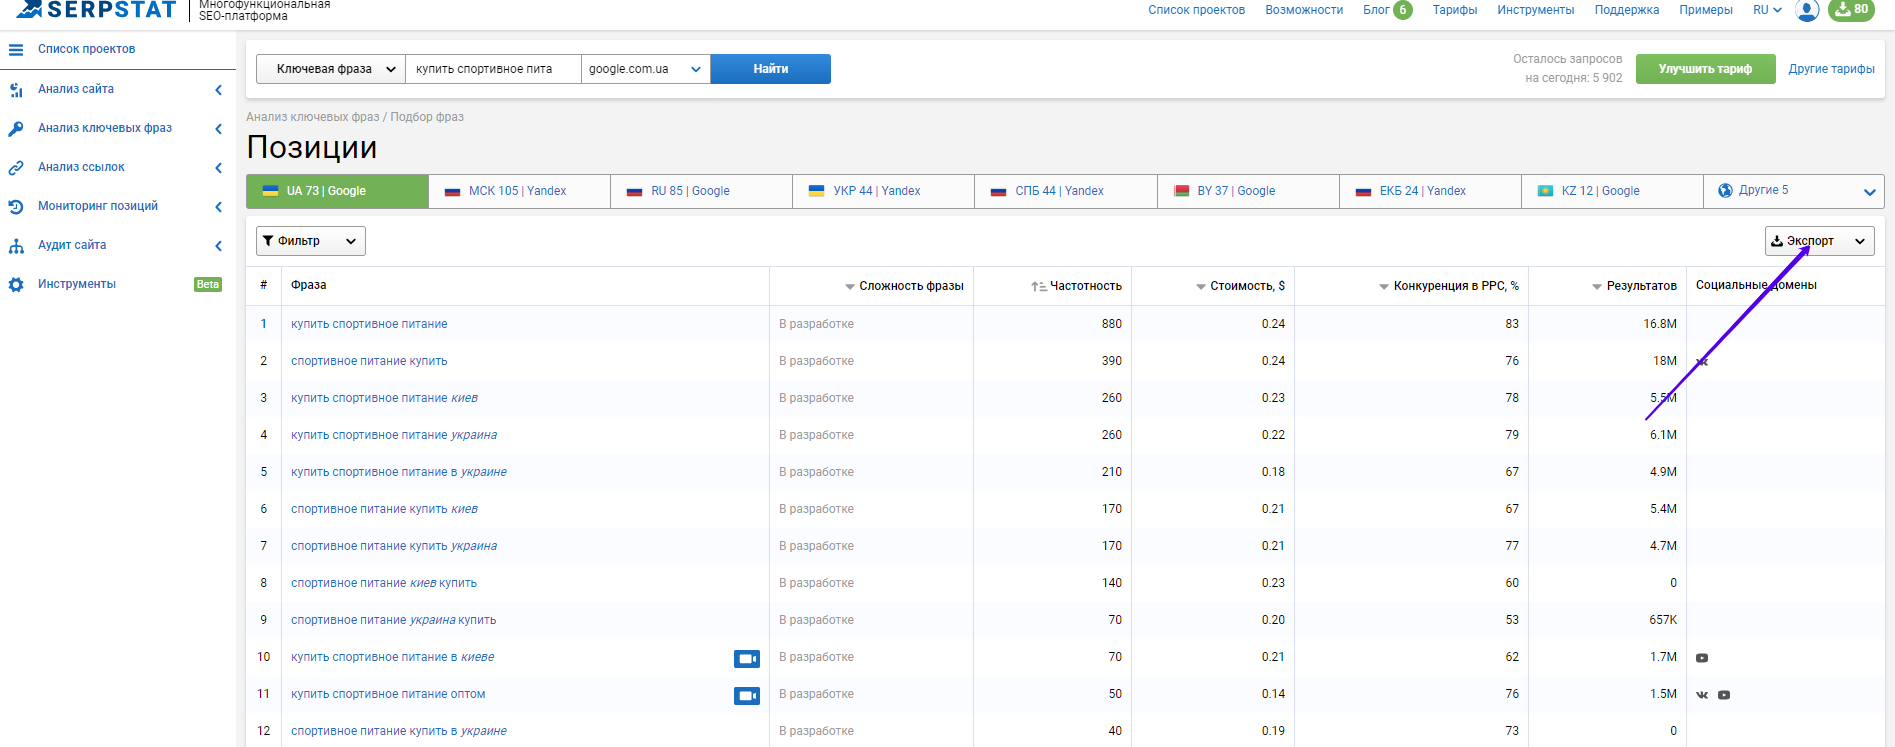
3.2 KeyCollector + Serpstat API
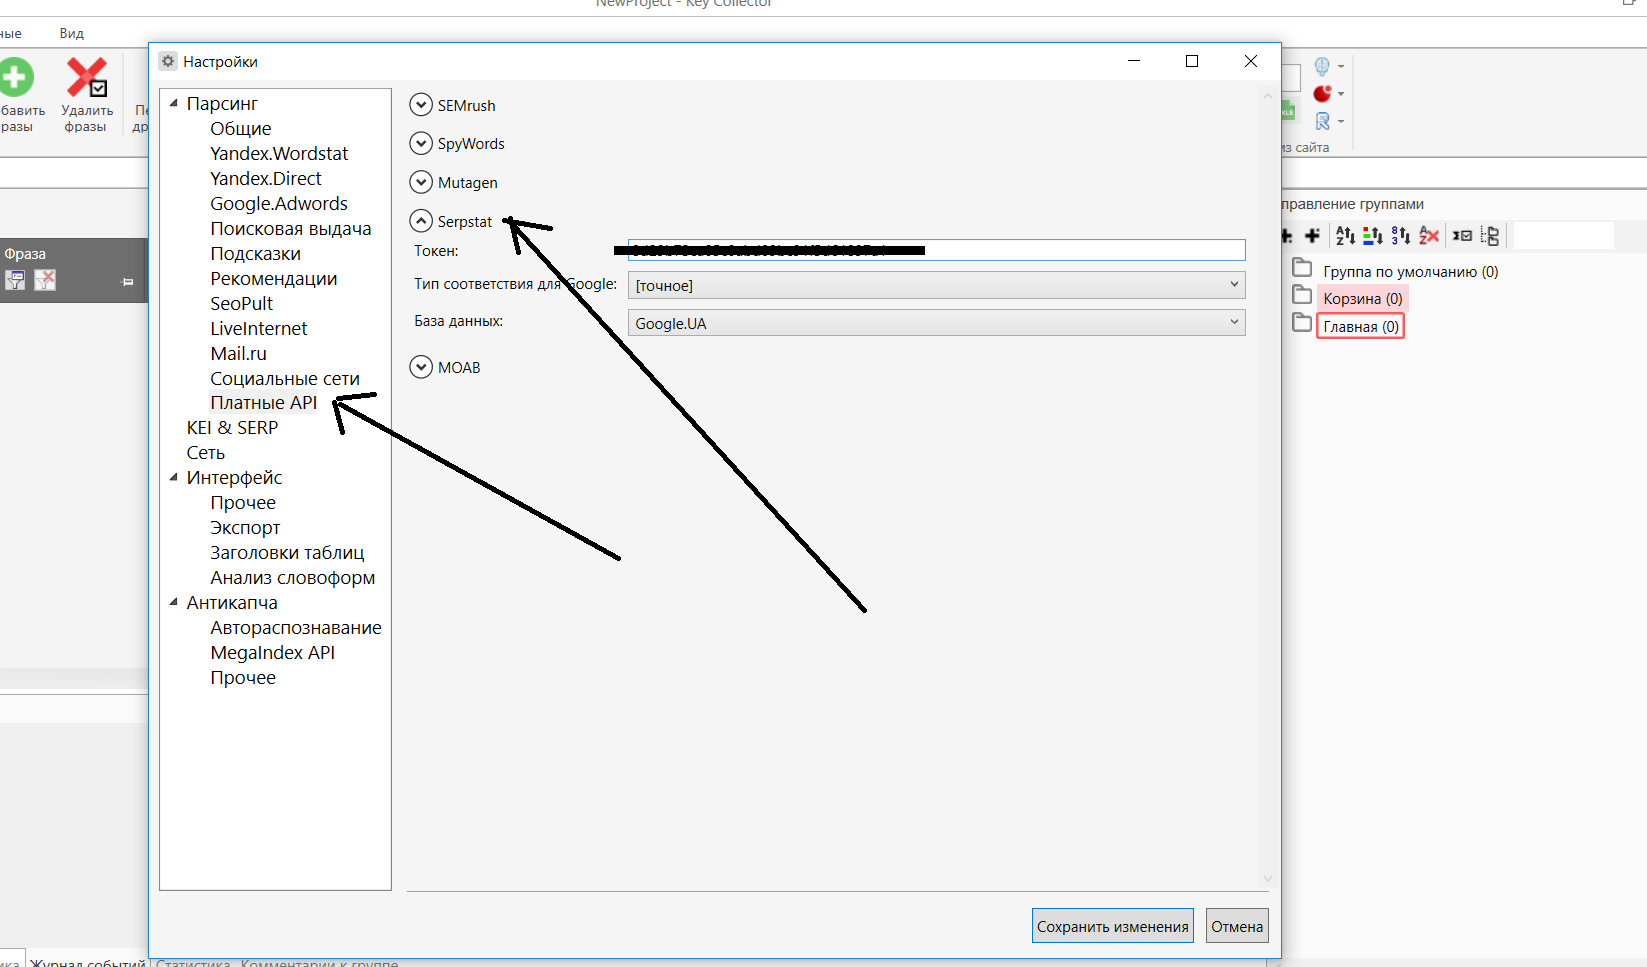
Попередній спосіб непоганий, але займає багато часу на пошук потрібних ключових для вступних даних та об’єднання вивантажених таблиць. Тому відразу на цьому етапі бажано використовувати автоматизацію, наприклад, KeyCollector.Для цього також знадобиться Serpstat API, заходимо в налаштування, вказуємо доступ до API
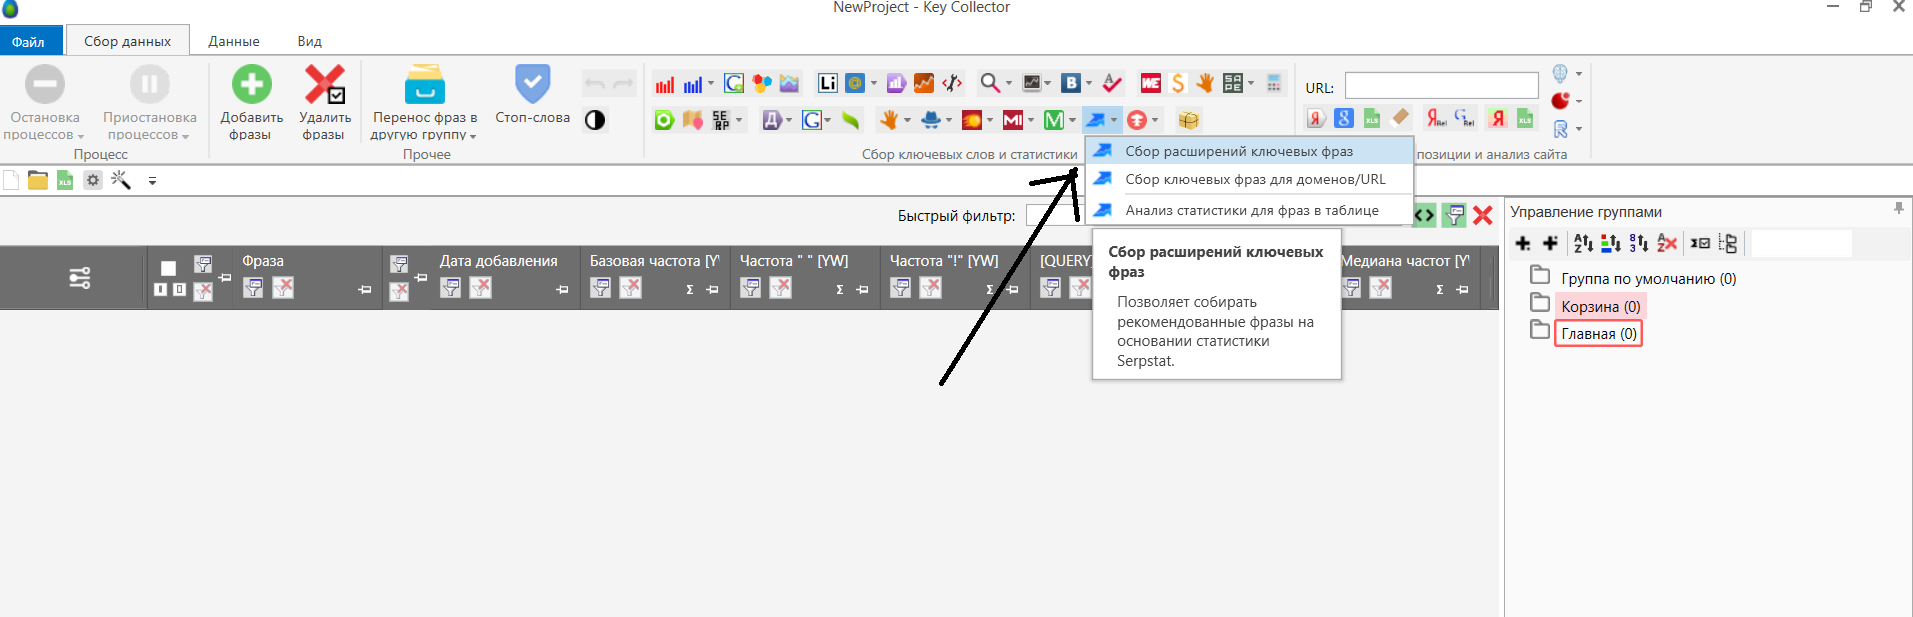
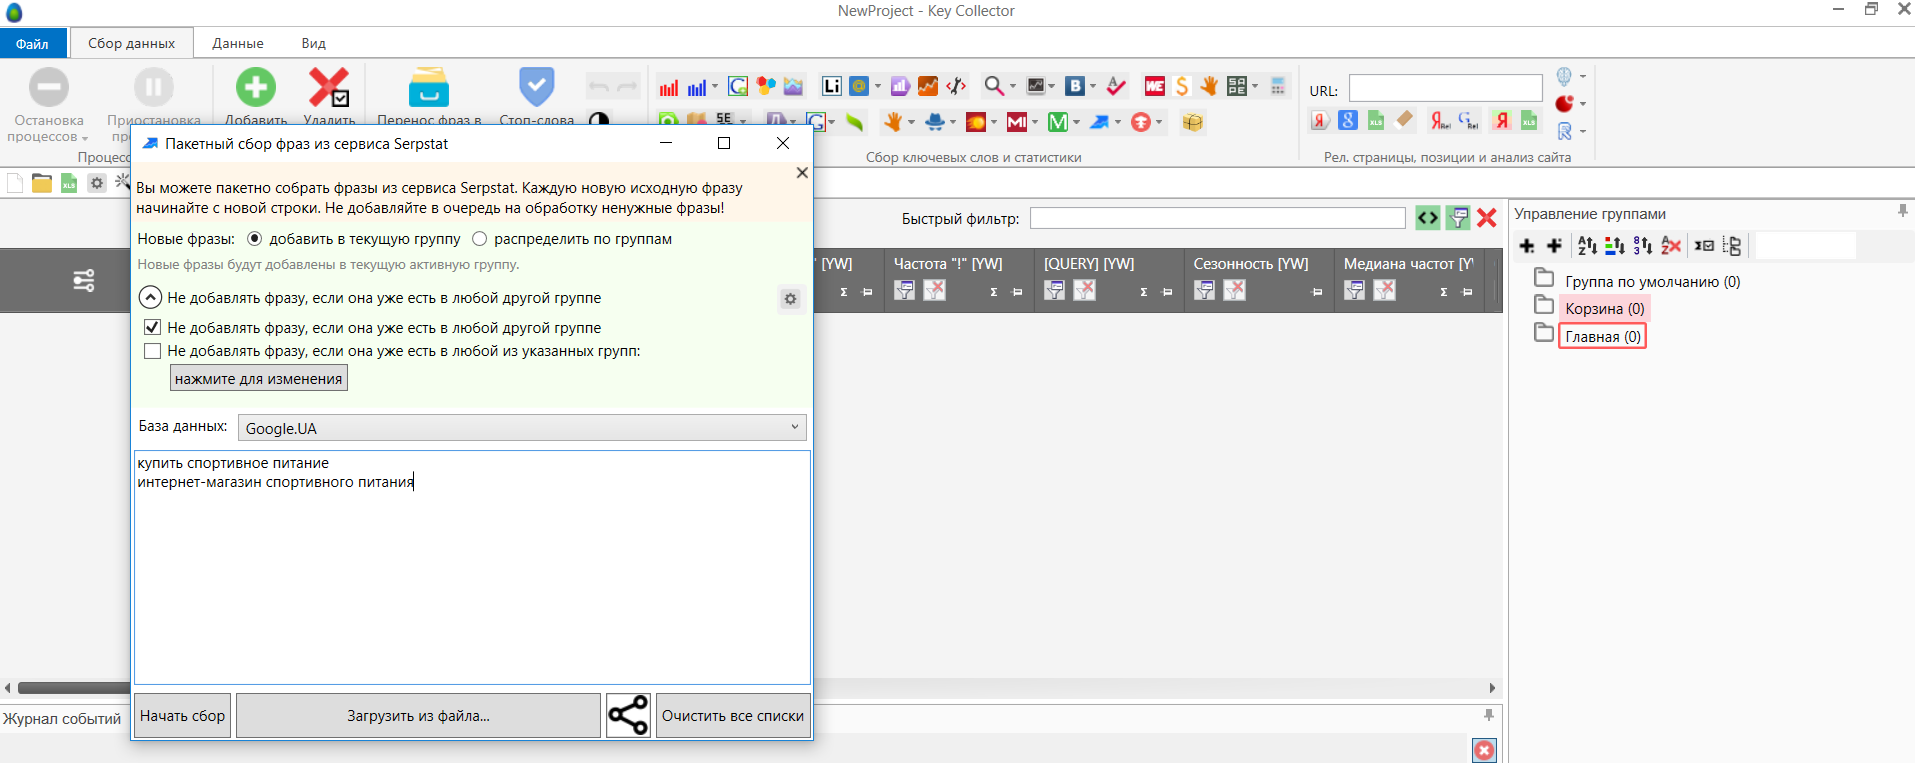
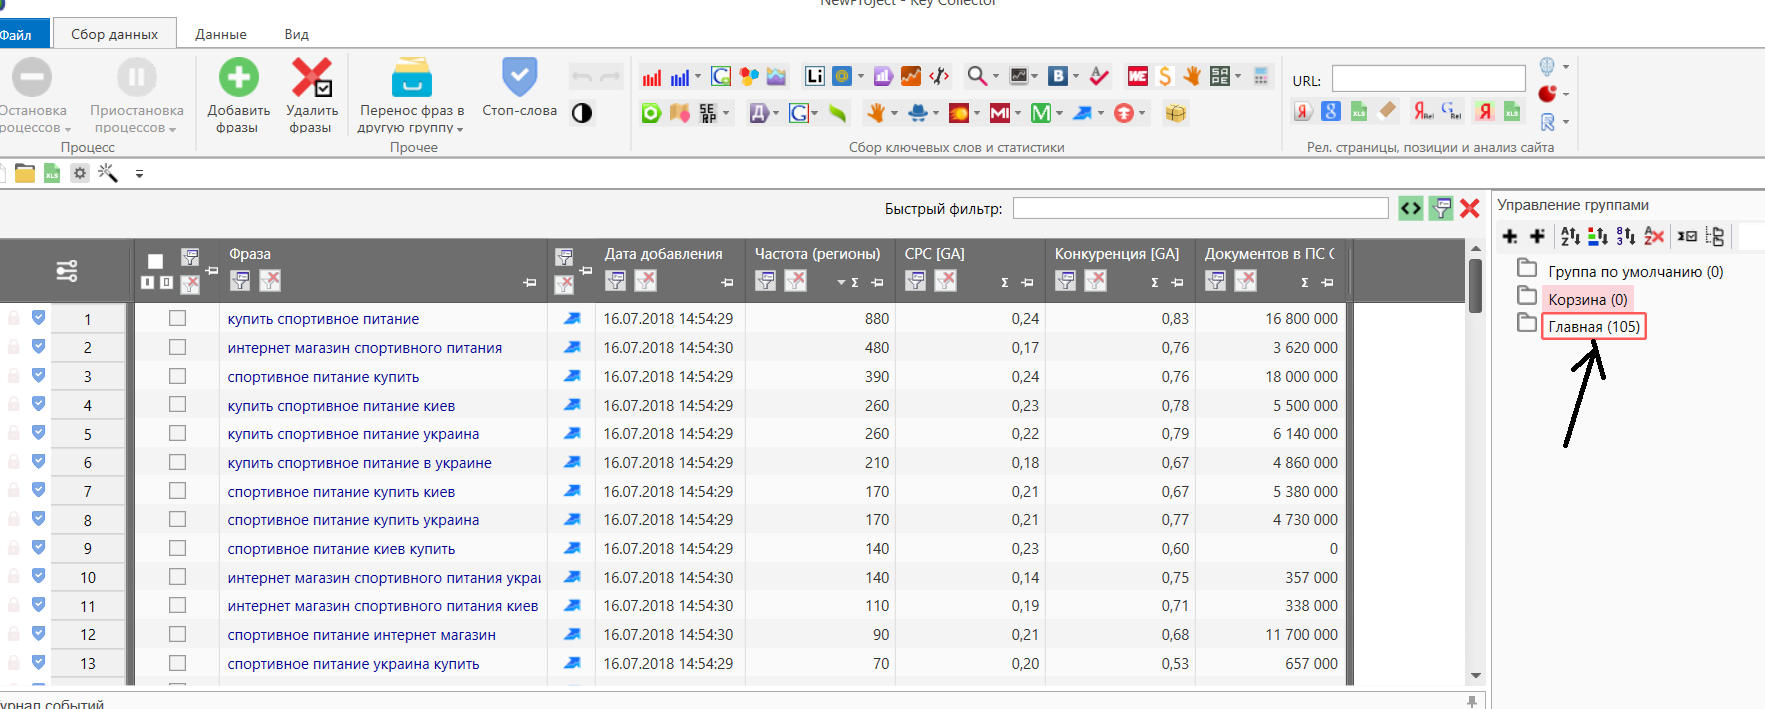
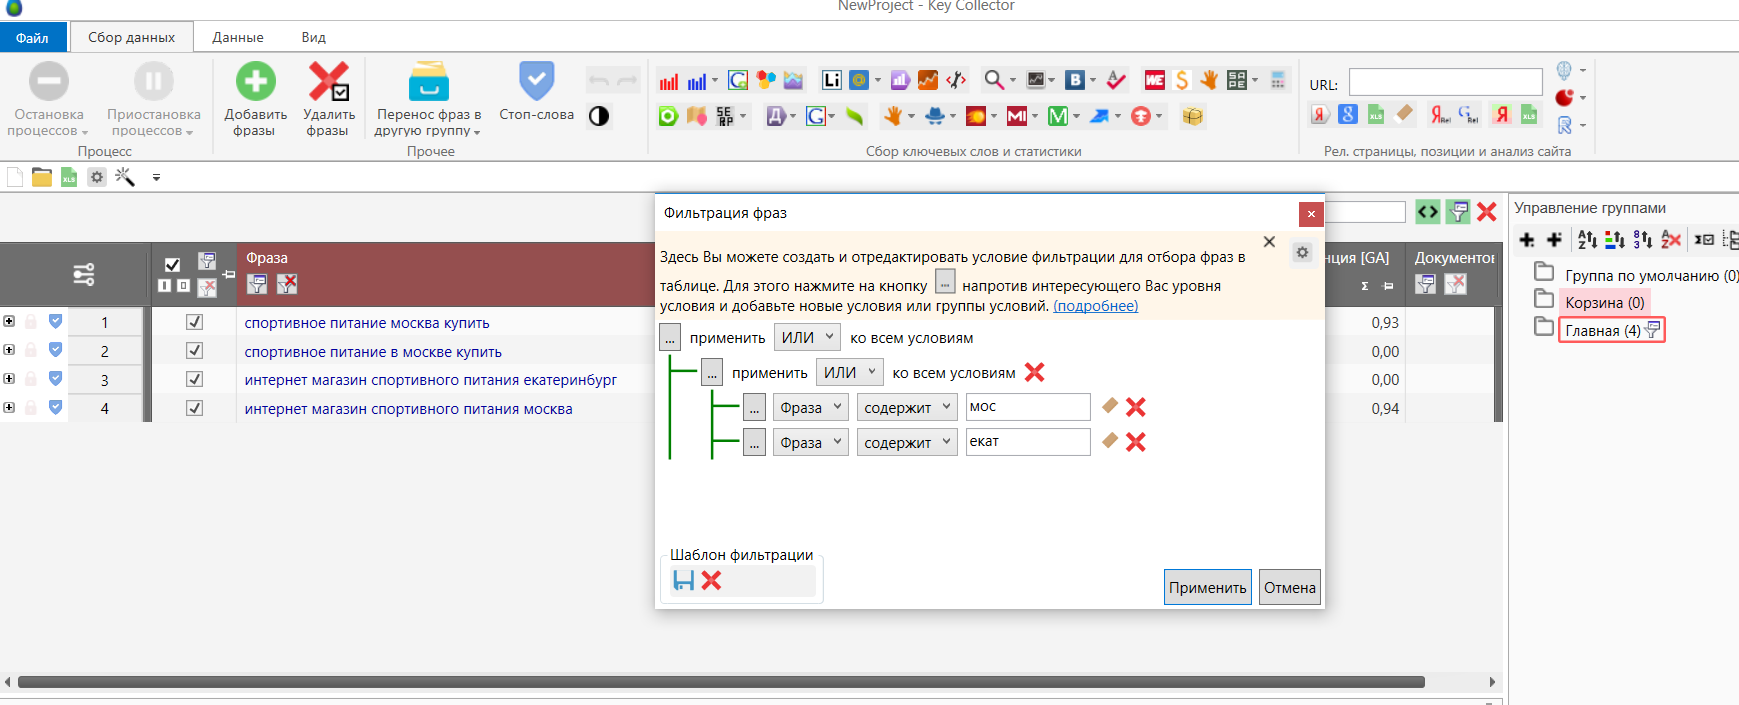
3.3 Google Spreadsheet API Serpstat
Для тих, хто не має такого інструменту як keycollector, також є рішення від наших колег і конкурентів Netpeakhttps://docs.google.com/spreadsheets/d/1-uZkbL7PM43PjebxpmygXNO9CUb1acqV31_VMmoVr8I/edit#gid=1120839304
Тут можна отримати ключі в Google Spreadsheet по API serpstat, не звертаючись в інтерфейс і не завантажуючи файли по одному ключовому.
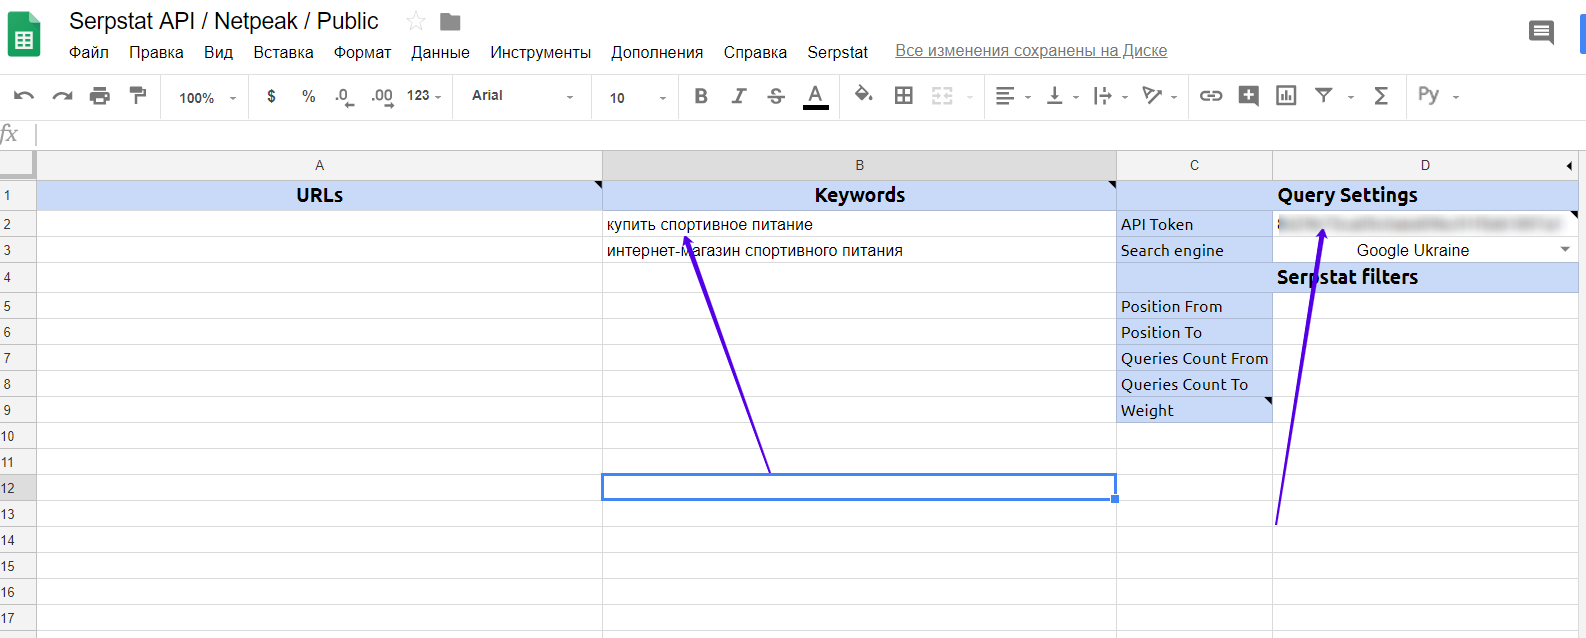
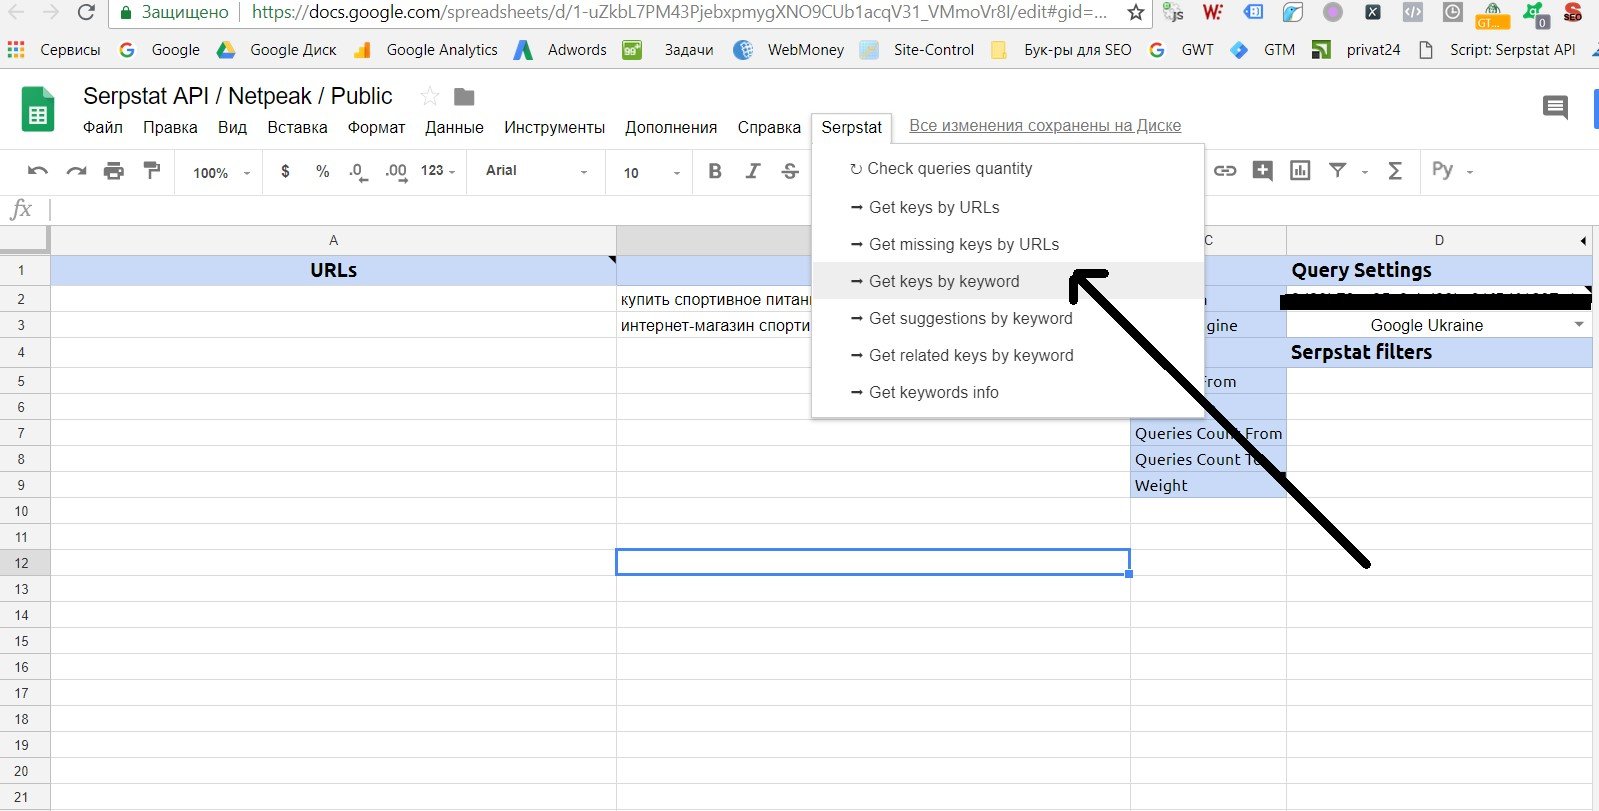
Як ви вже напевно помітили, скрізь потрібний доступ до сервісу Serpstat, чому в більшості випадків не використовуємо планувальник Adwords та Yandex Wordstat?
Тому що:
- Релевантність запитів набагато вища тим, що задаються як вихідні, а значить економиться час при чищенні.
- Швидкість отримання даних у рази вища, знову ж таки, економія часу
- Немає проблем з безліччю акаунтів і обмежень, обмеження лише на рядків API сервісу.
4. Автоматизації збору СЯ
Перед описом технічних моментів опишу алгоритм і логіку, а технічну реалізацію такого методу можна зробити різними способами, у нас це шаблон zennoposter у вас може бути веб-скрипт або Google Spreadsheet.Отже, логіка процесу:
Як швидко отримати ключові слова за конкурентною групою запитів за допомогою одного ключового? Найпростіший спосіб знайти конкурента, який добре ранжується, і його сторінка дуже схожа на вашу та отримати дані з Serpstat.
Щоб знайти такого конкурента йдемо в пошук потрібного нам пошуковика і шукаємо за потрібним запитом, наприклад, “купить спортивное питание”. Отримуємо таку видачу:
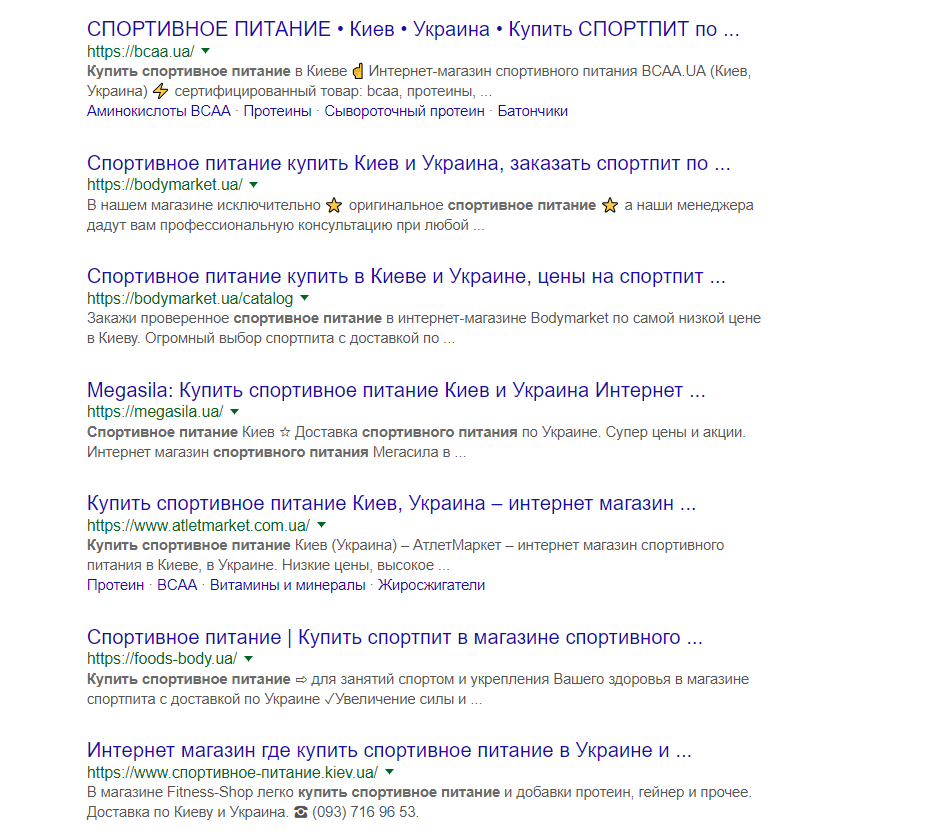
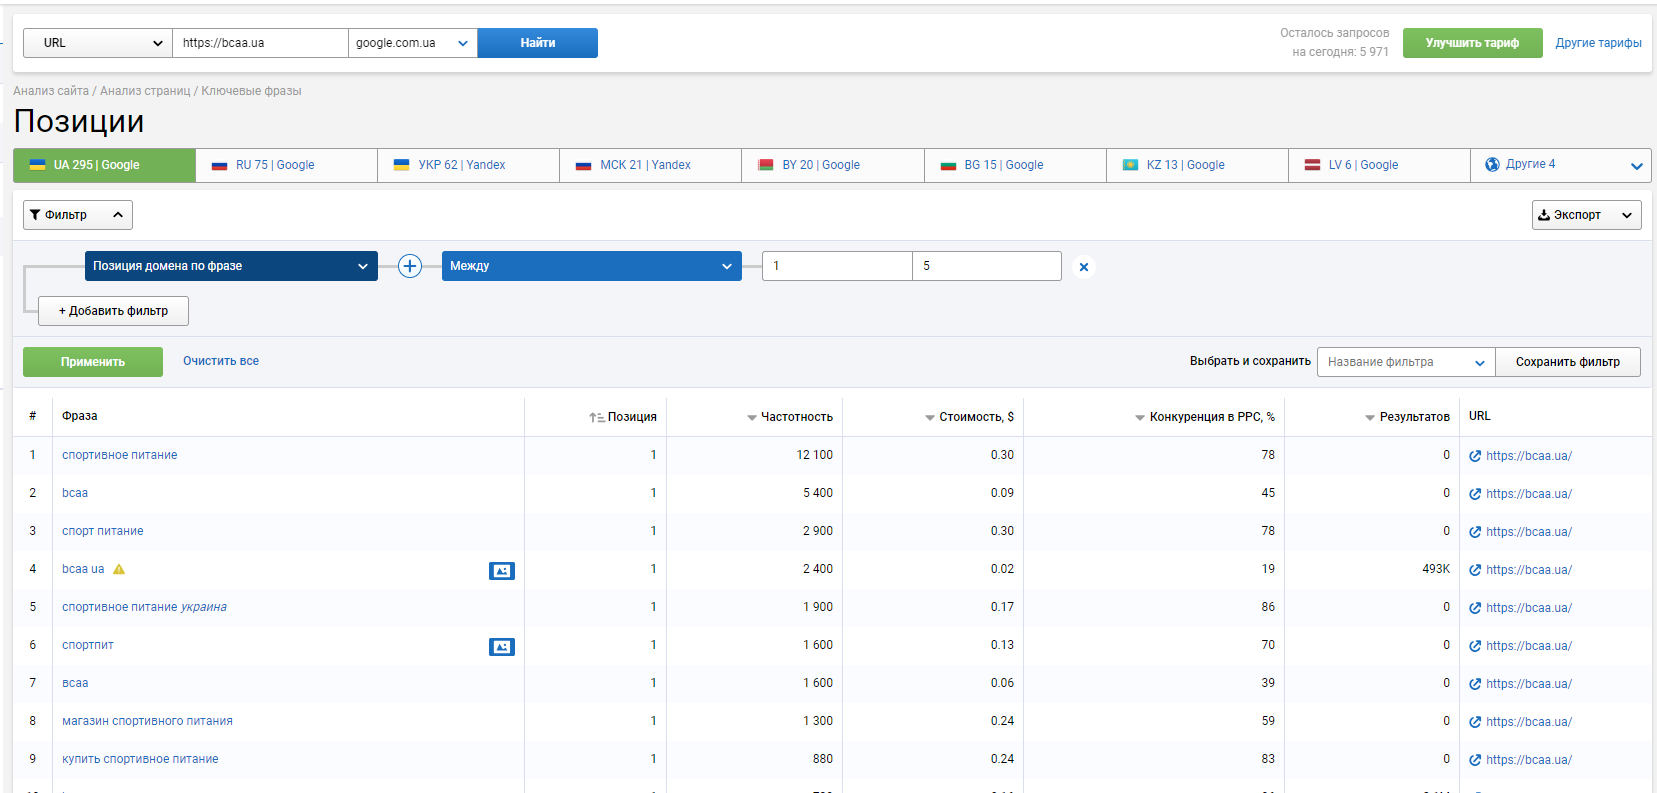
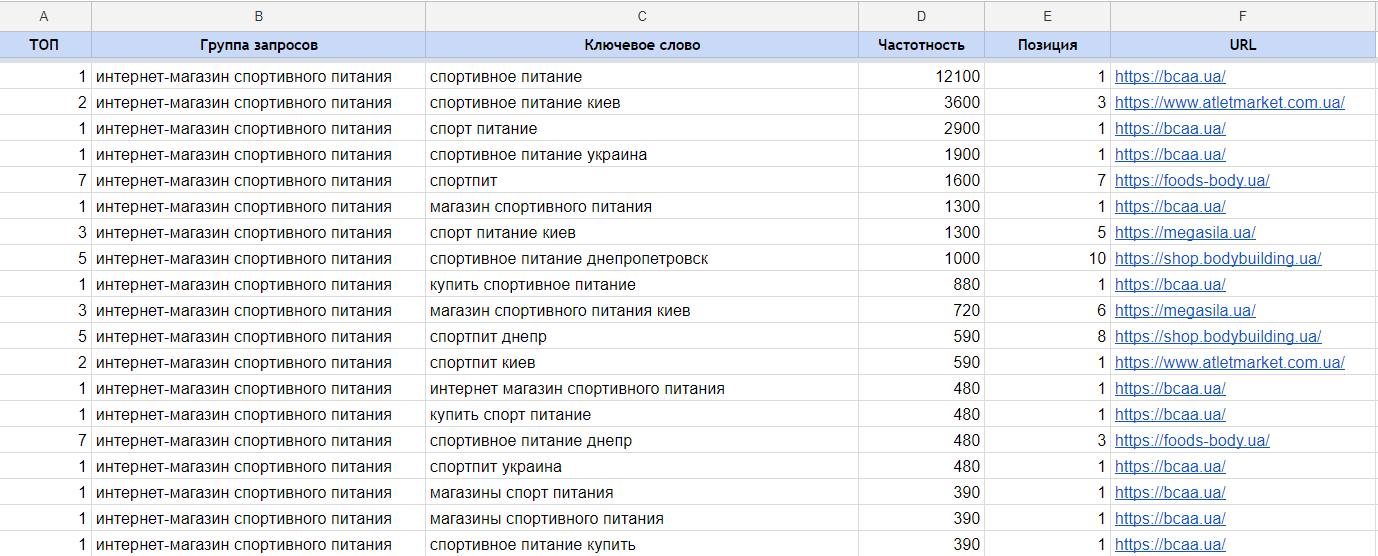
Аналогічно робимо для інших груп. Тобто на вході нам потрібно зібрати по одному ключовому слову для кожної групи, наприклад:
- Інтернет-магазин спортивного харчування
- Купити протеїни
- Купити креатин
Ідею та алгоритм я описав, а технічна реалізація за вами. Скажу лише, що в зеннопостері реалізувати таку автоматизацію з відправкою даних у Google Spreadsheet не складе значних труднощів навіть без досвіду програмування.
5. Що таке кластеризація ключових слів
Кластеризація - це розподіл ключових слів за кластерами (групами) на основі семантичної або логічної схожості ключових слів у кластері. Кластеризація буває кількох видів:5.1. Автоматична кластеризація на основі семантичної схожості фраз
Наприклад, є ключові:- Спортивне харчування
- Купити спортивне харчування Київ
Загальна частина цих запитів “спортивне харчування” і об’єднуються вони саме за семантичною схожістю. Цей метод дозволяє прискорити процес угруповання, але в нього багато неточностей і потім витрачається час на їх виправлення, а також запити на кшталт “інтернет-магазин спортивного харчування” вже не потраплять до групи, хоча логічно, що “інтернет-магазин спортивного харчування” та “ купити спортивне харчування” бажано просувати на головну сторінку, тобто в одному кластері.
5.2. Ручна кластеризація на основі логічної релевантності фраз
Наприклад:- Інтернет-магазин спортивного харчування
- Купити спортивне харчування
5.3. Автоматична кластеризація на основі ТОП пошукових систем
Автоматична кластеризація передбачає використання спеціальних сервісів, які мають статистику з ТОП пошукових систем, які запити переважно використовуються у конкурентів, що знаходяться в ТОПі в рамках однієї групи. Щоб було зрозуміліше наведу приклад: є запити “закрытые женские купальники” і “сдельные женские купальники”, якщо робити кластеризацію за семантичною схожістю, то це будуть різні групи, а якщо на підставі ТОПу, то бачимо, що Google чудово розуміє, що це одна група запитів, тобто не потрібно робити кілька груп.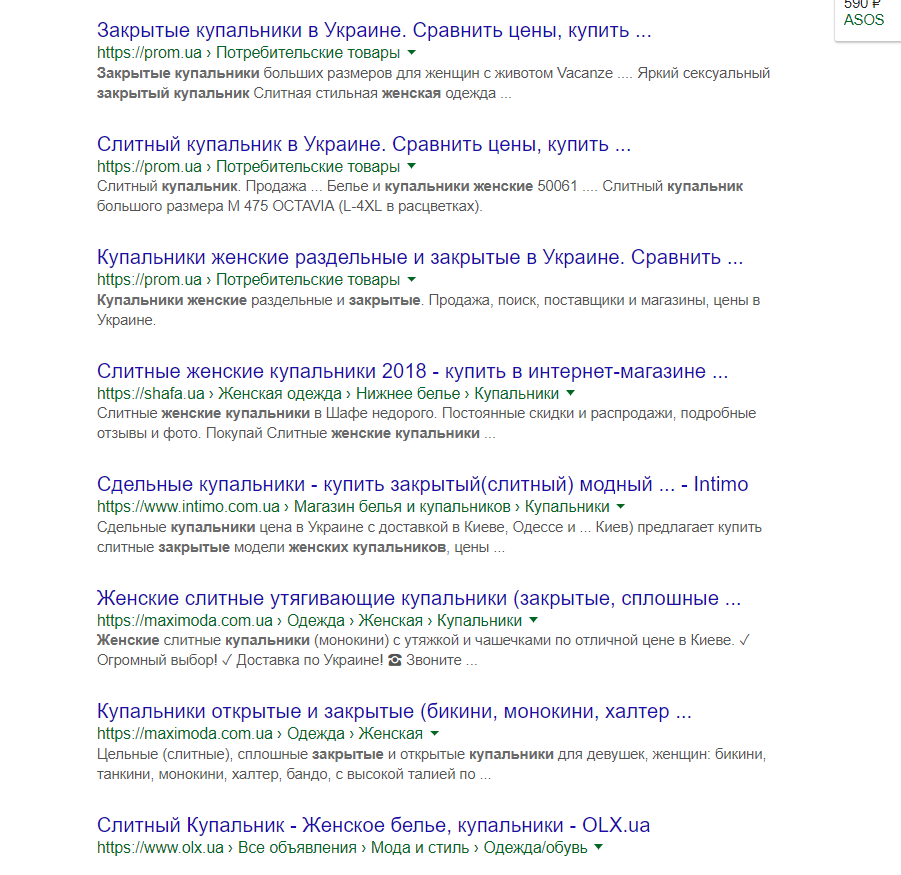
6. Інструменти для кластеризації ключових слів
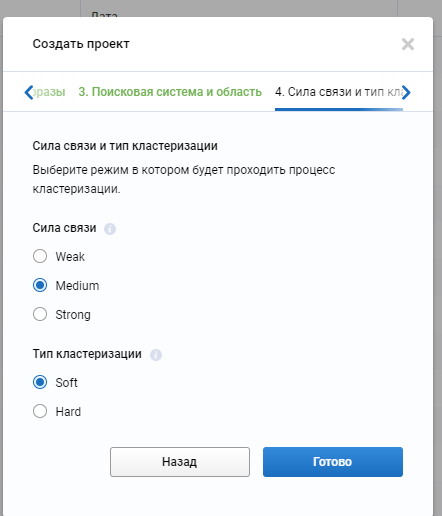
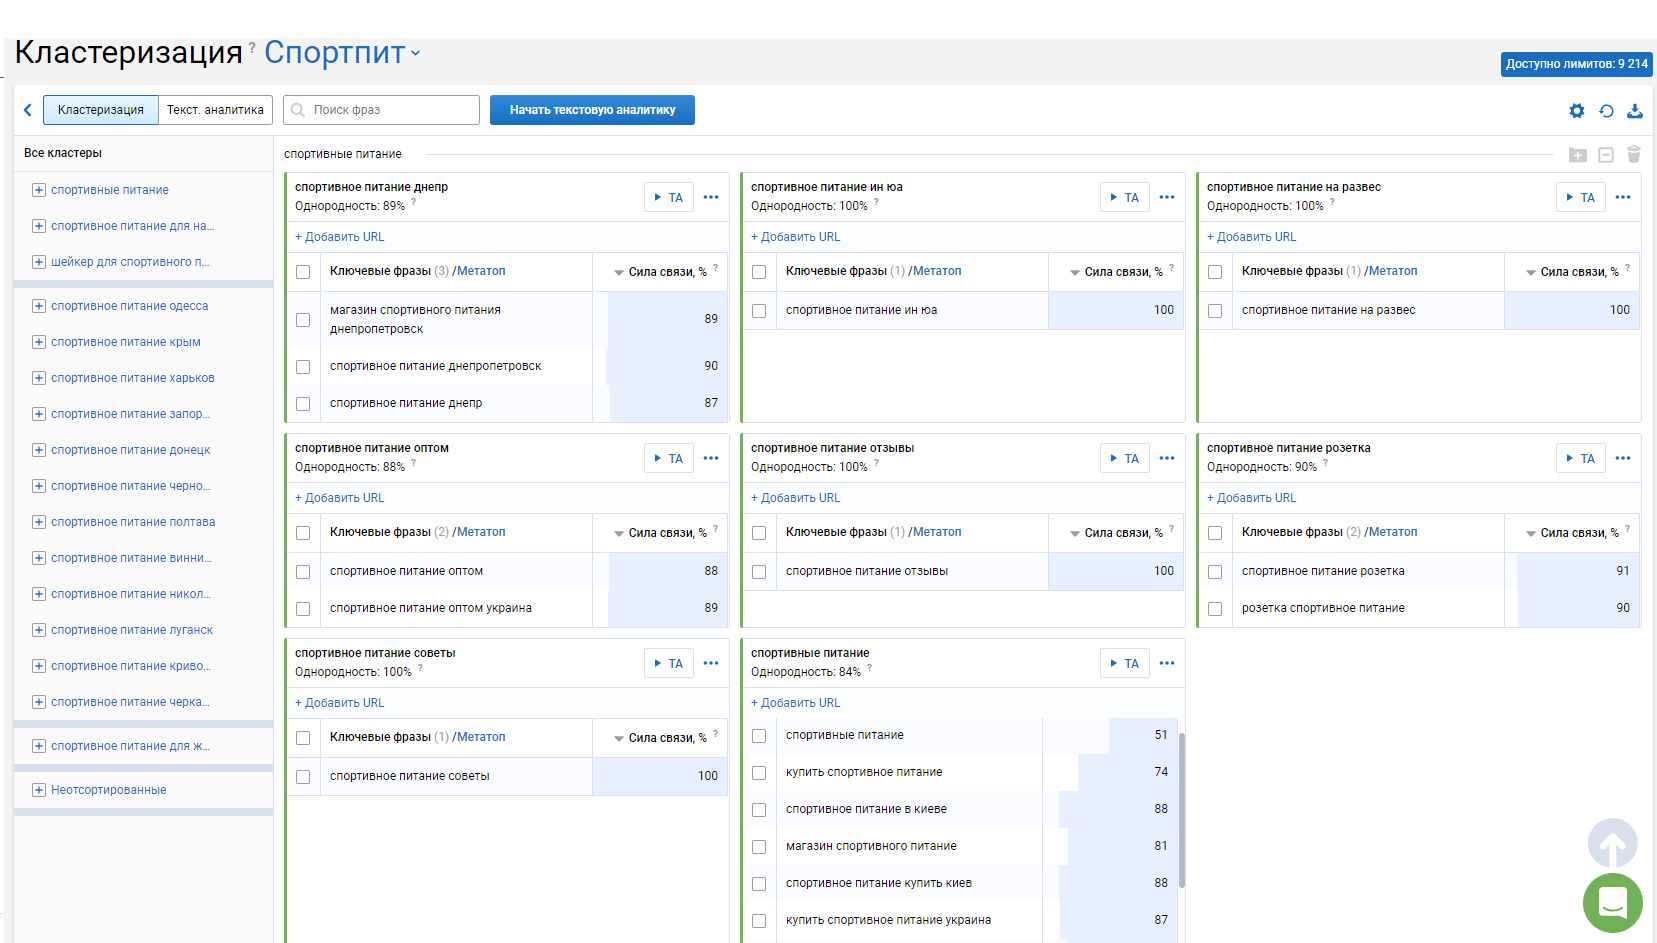
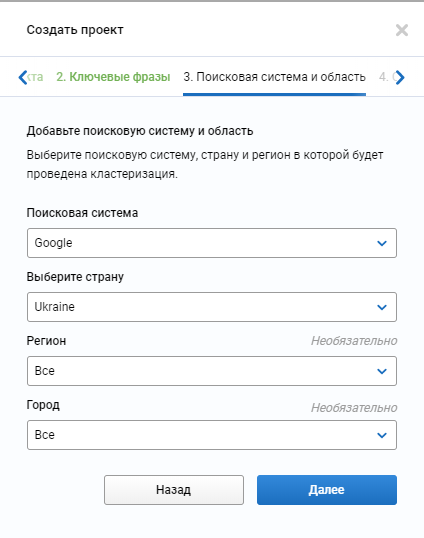
Для всіх сервісів потрібен список ключових слів для подальшої їх кластеризації. Як швидко зібрати ми вже розуміємо, тож перейдемо одразу до інструментів. Як ви, напевно, вже здогадалися використовуватимемо Serpstat. Беремо список ключових, заходимо у розділ кластеризація, створюємо проєкт, додаємо ключі.Далі вказуємо регіон:
- Weak - слабкий зв’язок між фразами.
- Strong - сильний зв’язок між фразами.
- Soft - запити об’єднуються в групу, якщо є загальний набір URL хоча б для однієї пари.
- Hard - запити об’єднуються в групу тільки якщо є загальний для всіх набір URL.